- DB 설계
- 저장공간 설계
- 무결성 설계
- 인덱스 설계
- 분산 설계
- 보안 설계
- DB 이용
- DBMS
- 데이터 액세스
- 트랜잭션
- 백업 및 복구
- DB 성능 개선
- 성능 개선 방법론
- 조인(Join)
- 애플리케이션 성능 개선
- 서버 성능 개선
DB
데이터 무결성
├─ 엔티티 무결성
├─ 영역 무결성
└─ 참조 무결성
| 구분 | 의미 | 핵심 규칙 | 대표 구현 |
|---|---|---|---|
| 데이터 무결성 | 데이터가 정확성·일관성·유효성을 유지하는 성질 | 전체적인 상위 개념 | 각종 제약조건, 업무 규칙 |
| 엔티티 무결성 | 하나의 엔티티 내 각 인스턴스를 유일하게 식별할 수 있어야 함 | PK는 UNIQUE + NOT NULL | PRIMARY KEY |
| 영역 무결성 | 속성값이 정의된 도메인 범위 내의 값이어야 함 | 타입, 길이, 범위, 허용값, NULL 여부 등 | DATA TYPE, CHECK, DEFAULT, NOT NULL |
| 참조 무결성 | 자식이 참조하는 부모 인스턴스가 실제로 존재해야 함 | FK 값은 부모 PK/UK 값과 일치하거나 NULL | FOREIGN KEY |
- 영역 무결성 (도메인 무결성)
- 칼럼에 적용되어 단일 로우의 칼럼 값만으로 만족 여부를 판단
- 데이터 타입 & 길이
- 유효값 (CHECK, IN)
- NOT NULL
| 인덱스 종류 | 핵심 개념 | 주요 특징 / 용도 |
|---|---|---|
| 트리 기반 인덱스 | B+ Tree 계열 구조 | 범위검색에 유리, OLTP에서 일반적으로 사용 |
| 해시 기반 인덱스 | 해시 함수로 버킷 탐색 | 정확히 일치하는 값 검색에 유리 |
| 비트맵 인덱스 | 값별 비트맵 생성 | 낮은 선택도, 다중 조건 검색, OLAP에 유리 |
| 함수 기반 인덱스 | 함수/수식 계산 결과에 인덱스 생성 | 컬럼을 가공한 조건 검색에 활용 |
| 비트맵 조인 인덱스 | 조인된 테이블의 컬럼값으로 비트맵 인덱스 생성 | DW/OLAP의 조인 비용 감소 |
| 도메인 인덱스 | 사용자 정의 인덱스 | 특수 데이터/검색 방식에 맞춤 |
| 클러스터 인덱스 | B+ Tree 계열 구조, 인덱스 키 순서와 데이터 저장 순서를 연계 | 범위검색 유리, DML 유지비용 증가 |
| 파티션 인덱스 | 인덱스를 파티션 단위로 구성 | 대용량 파티션 테이블 관리/검색 |
| 종류 | 특성 |
|---|---|
| B-Tree | 값 종류 많음 + 범위검색 + OLTP |
| Hash | = 검색 |
| Bitmap | 값 종류 적음 + 다중조건 + OLAP |
| Function-Based | 함수/수식 결과를 인덱싱 |
| Bitmap Join | 조인 결과 컬럼을 Bitmap으로 인덱싱 |
| Domain | 사용자 정의 인덱스 |
| Clustered | 데이터 물리 저장 순서와 인덱스 키 연계 |
| Local Partition | 테이블 파티션과 인덱스 파티션 1:1 |
| Global Partition | 테이블 파티션과 독립적 |
| 영역 | 비고 |
|---|---|
| Heap Table | 정렬 없이 저장, INSERT 부담 적음 |
| Clustered Table | 인덱스 키 순서와 데이터 저장 순서 연계 |
| Range Partition | 범위, 특히 날짜 |
| List Partition | 코드/지역 |
| Hash Partition | 균등 분산, 성능/경합 감소 |
| Composite | 파티션 + 서브파티션, 순서 중요 |
| External | 외부 파일을 테이블처럼 사용 |
| Temporary | 세션/트랜잭션 임시 저장 |
| 컬럼 배치 | 고정/NOT NULL 앞, 가변/NULL 많음 뒤 |
| 수직 분할 | Row가 너무 크거나 컬럼 사용빈도 편차가 큼 |
| Tablespace | 논리 저장공간 |
| Data File | 물리 저장공간 |
| 대용량 테이블 | 독립 Tablespace 고려 |
| LOB | 별도 저장공간 고려 |
| 용량 설계 | 분석 → 객체 → Tablespace → Disk |
| I/O 설계 | 병목 최소화 및 분산 |
- 테이블 설계시 고려사항
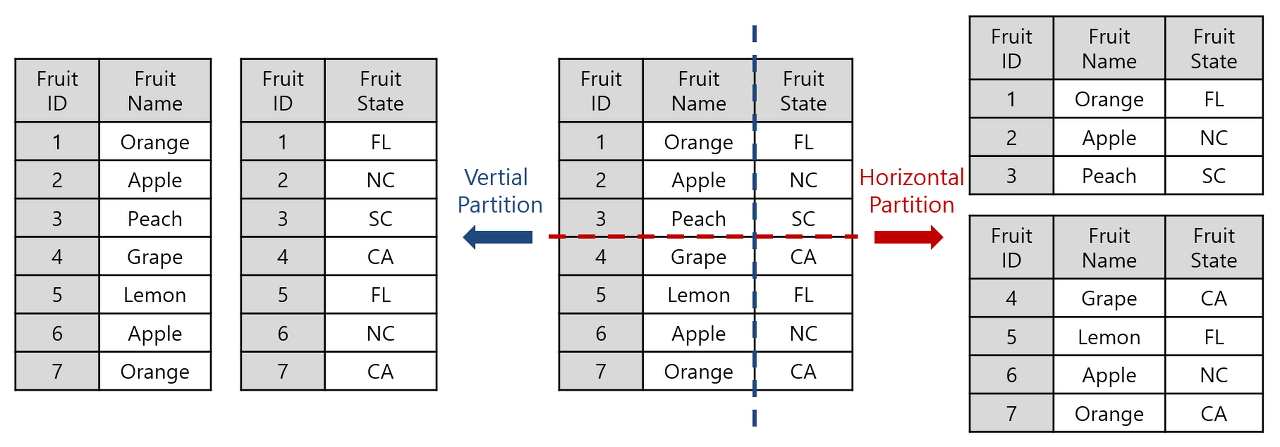
- 칼럼 데이터 길이 합이 1 블록 사이즈보다 큰 경우 수직 분할
- 칼럼 길이가 길고 특정 칼럼의 사용 빈도 차이가 심한 경우 수직분할
- 테이블과 인덱스는 분리하여 저장하면 I/O병목을 최소화
- 임시세그먼트는 독립적인 공간을 사용하는 것이 좋음
- 분류 작업이 진행되는 동안, DB 내부에서 객체가 생성되는 동적 특성을 가지기 때문
- 테이블과 테이블스페이스
- 데이터 파일은 물리적인 저장공간
- 테이블스페이스는 논리적인 저장공간
- 테이블은 테이블스페이스라는 논리적인 단위를 이용하여 관리
- 테이블스페이스는 물리적인 데이터 파일을 지정하여 저장
- 데이터용/인덱스용 테이블스페이스 설계 유형
- 테이블이 저장되는 테이블 스페이스는 업무별로 지정
- 대용량 테이블은 독립적인 테이블 스페이스 지정
- 테이블과 인덱스는 분리 저장
- LOB 타입 데이터는 독립적인 공간 지정
- 용량설계
- 목적
- 정확한 데이터 용량을 예측하여 저장공간을 효과적인 사용과 저장 공간에 대한 확장성을 보장하여 가용성을 높이기 위함
- H/W 특성을 고려하여 디스크 채널 병목을 최소화
- 디스크 I/O를 분산하여 접근 성능을 향상
- 테이블이나 인덱스에 맞는 저장 옵션 지정
- 테이블 저장 옵션에 대한 고려사항
- 초기 사이즈, 증가 사이즈
- 트랜잭션 관련 옵션
- 최대 사이즈와 자동 증가
- 저장 용량 설계 절차
- 목적
| 절차 | 비고 |
|---|---|
| 용량 분석 | 데이터 증가 예상 건수, 주기, 로우 길이 등을 고려함 |
| 오브젝트별 용량 산정 | 테이블, 인덱스에 대한 크기 |
| 테이블스페이스별 용량 산정 | 테이블스페이스별 오브젝트 용량의 합계 |
| 디스크 용량 산정 | 테이블스페이스에 따른 디스크 용량과 I/O 분산 설계 |
DB 내부에서 모든 무결성 제약을 정의할 수는 없다.
- 클러스터 인덱스에서 말하는 SPLIT(Page Split)
- 인덱스 키 순서를 유지해서 데이터를 저장해야 하는데
- 기존 데이터 페이지에 빈 공간이 부족할 때
- 페이지를 둘로 나누는 현상
| 구분 | B-TREE | BITMAP |
|---|---|---|
| 구조 특징 | Root block, branch block, leaf block으로 구성되며, 인덱스 깊이를 동일하게 유지하는 트리 구조 | 키 값이 가질 수 있는 각 값에 대해 하나의 비트맵을 구성 |
| B+ 트리는 키 값에 Rowid 리스트를 저장 | 비트맵에서 비트의 위치는 테이블에서 로우의 상대적인 위치를 의미하므로 해당 테이블이 시작되는 물리적인 주소만 알면 실제 로우의 물리적인 위치를 계산 | |
| 사용 환경 | OLTP | DW, Mart 등 OLAP |
| 검색 속도 | 처리 범위가 좁은 데이터 검색 시 유리함 | 다중 조건을 만족하는 데이터 검색 시에 유리함(특히, 비정형 쿼리) |
| 분포도 | 데이터 분포도가 좋은 칼럼에 적합 | 데이터 분포도가 나쁜 칼럼에 적합 (ex. 성별) |
| 장점 | 입력, 수정, 삭제가 용이함 | 비트 연산으로 OR 연산, NULL 값 비교 등이 가능함 |
| 단점 | 처리 범위가 넓을 때 수행 속도 저하 | 전체 인덱스 조정의 부하로 입력, 수정, 삭제가 어려움 |
| 루트에서 리프 노드까지 모든 경로의 깊이가 같음 데이터 삽입과 삭제 성능 우수-모든 키값은 리프노트에 존재하며, 양방향 연결됨 범위검색시 성능 우수 B+트리 각 노드는 최소한 반이상 차 있어야 함 B* 트리 각 노드는 최소한 2/3 이상 차 있어야 함 인덱스를 생성한 컬럼을 가공하면 인덱스 사용 불가 인덱스를 생성한 컬럼순으로 정렬됨 분포도가 나빠지면 수행속도 저하 | 저장공간과 I/O를 감소 |
- LOB 타입 데이터는 독립적인 공간을 지정한다
- LOB 데이터가 크고 I/O 특성이 일반 행 데이터와 다르므로 일반 테이블 데이터와 별도의 저장공간/테이블스페이스에 분리해서 관리하는 것이 바람직하다
LOB = 대용량 객체 데이터
크기가 크고 I/O 특성이 다름 → 독립 저장공간 고려
인덱스 매칭도란 인덱스에서 처리범위를 결정하는데 참여한 술어의 수를 의미한다.
4. 분산설계
- 분산DB 개요
- 하나의 논리적 DB가 네트워크상에서 여러 컴퓨터에 물리적으로 분산되어 있지만 사용자가 하나의 DB처럼 인식할 수 있도록 논리적으로 통합된 DB
- 원격 데이터에 대한 의존도 감소
- 단일 서버에서 불가능한 대용량 처리가 가능
- 기존 시스템에 서버를 추가하여 점진적 증가가 용이
- 장애전파가 안되어 신뢰도와 가용성이 향상
- 분산 설계 전략
- 중앙 집중형 DB처럼 한 컴퓨터에서만 DB를 관리하고 여러 지역에서 접근할 수 있도록 하는 방식
- 지역 DB에 데이터를 복제하고 실시간으로 복제본을 갱신하는 방식
- 지역 DB에 데이터를 복제하고 주기적으로 복제본을 갱신하는 방식
- 데이터 분할 시 전체 지역 DB를 하나의 논리적 DB로 유지하는 방식
- 데이터 분할 시 각각의 지역 DB들을 독립된 DB로 유지하는 방식
- 분산 DBMS 투명성
| 종류 | 비고 |
|---|---|
| 분할 투명성 | 전역 스키마가 어떻게 분할되어있는지를 알 필요가 없음 |
| 위치 투명성 | 데이터의 물리적인 위치도 알 필요가 없음 |
| 중복 투명성 | 어떤 데이터가 중복되었는지, 어디에 중복 데이터를 보관하고 있는지 알 필요가 없음 |
| 장애 투명성 | DB가 분산되어 있는 시스템이나 네트워크에 장애가 발생하더라도 데이터의 무결성 보장 |
| 병행 투명성 | 다수 트랜잭션이 동시에 수행되어도 결과의 일관성 유지 (Locking, Timestamp) |
- 분산 설계 방식
- 테이블 위치 분산
- 테이블이 전역적으로 중복되지 않음. 테이블마다 위치를 다르게 지정 > 테이블마다 존재할 서버를 결정
- 할당 (Allocation)
- 동일한 분할을 복수 서버에 생성하는 분산 방법
- 분할의 중복이 존재하는 할당 방법과 중복이 존재하지 않는 할당 방법으로 구분
- 부분 복제: 전역 서버 테이블의 일부 데이터를 지역 서버에 복제
- 광역 복제: 전역 서버 테이블의 전체를 지역 서버에 복제
- 분할 (Fragmentation)
- 테이블 위치 분산
| 구분 | 의미 |
|---|---|
| 완전성 / 재구성 / 상호중첩배제 | 데이터를 분할할 때 반드시 만족해야 하는 규칙 |
| 수평분할 / 수직분할 | 데이터를 어떤 방식으로 나눌 것인가 |
| 요소 | 비고 |
|---|---|
| 완전성 | 분할 시에 전역 릴레이션 내의 모든 데이터가 어떠한 손실도 없이 분할로 매핑 |
| 재구성 | 관계 연산을 사용하여 원래의 전역 릴레이션으로 재구성이 가능 |
| 상호 중첩 배제 | 분할 시 하나의 분할에 속한 데이터 항목이 다른 분할의 데이터 항목에 속하지 않아야 함 |
| 수평분할 | 특정 속성의 값을 기준으로 분할, 동일한 속성을 가진 상품을 지역적으로 분산하여 관리, 동일한 속성을 가질 경우 |
| 수직분할 | 속성을 기준으로 분할, 컬럼을 기준으로 분할, 상이한 속성을 가질 경우 |
                    Disk
                     ↑
               Block Device
                /          \
               /            \
    직접 접근               File System
   Raw 성격의 접근               ↑
                              일반 File
                              (Cooked)
| 구분 | 접근 방식 | 파일시스템 사용 | OS 버퍼/캐시 | 특징 |
|---|---|---|---|---|
| Raw Device | DBMS가 디스크/파티션을 직접 접근 | X | 우회하는 성격 | 빠르지만 관리 불편 |
| Block Device | OS의 블록 장치 인터페이스를 통해 블록 단위 접근 | X | 일반적으로 OS 블록 I/O 계층 사용 | 블록 단위 I/O |
| Cooked Device/File | 파일시스템 위의 일반 파일로 접근 | O | O | 관리 편리, 추가 오버헤드 존재 |
테이블 위치 분산은 전역적으로 테이블이 유일하게 존재한다.
게시글 본문처럼 큰 BLOB 데이터를 가진 테이블은 한 행의 크기가 커질 수 있고, IOT(Index Organized Table)는 행 데이터를 PK 인덱스의 리프 블록에 함께 저장하므로 큰 행에 불리하다. 따라서 게시글 본문 저장 테이블에 IOT를 쓰는 것은 일반적으로 적절하지 않다.
- 보안모델
| 이름 | 비고 |
|---|---|
| 접근 통제 행렬 (Access Control Matrix) | -임의적 접근 통제를 위한 보안 모델 -행은 주체, 열은 객체, 행&열은 주체와 객체가 가지는 권한의 유형 -주체: DB에 접근할 수 있는 조직의 개체. 일반적으로 객체에 대하여 접근을 시도하는 사용자 -객체: 보호되고 접근이 통제되어야 하는 DB의 개체. 테이블, 칼럼, 뷰, 프로그램, 논리적인 정보의 단위 -규칙: 주체가 객체에 대하여 수행하는 DB의 조작. 입력, 수정, 삭제, 읽기와 객체의 생성과 파괴 등 |
| 기밀성 모델 (Bell-Lapadula) | -군사용 보안 구조의 요구 사항을 충족시키기 위하여 정보의 불법적인 파괴나 변조 보다는 기밀성 유지에 초점을 둔 최초의 수학적인 모델 -단순 보안 규칙: No-Read-Up. 주체는 자신보다 높은 등급의 객체를 읽을 수 없음 -* (스타)-무결성 규칙: No-Write-Down. 주체는 자신보다 낮은 등급의 객체에 정보를 쓸 수 없음 -강한 * (스타) 보안 규칙: 주체는 자신과 등급이 다른 객체에 대하여 읽거나 쓸 수 없음 |
| 무결성 모델 Biba (BLP의 반대) | -정보의 일방향 흐름 통제를 이용하여 정보의 비밀성을 제공하는 기밀성 모델에서 발생하는 정보의 부당한 변경 문제를 해결하기 위해 개발된 무결성 기반의 보안 모델 -단순 보안 규칙: No-Read-Down. 주체는 자신보다 낮은 등급의 객체를 읽을 수 없음 -*(스타)-무결성 규칙: No-Write-Up. 주체는 자신보다 높은 등급의 객체에 정보를 쓸 수 없음 |
- 접근 통제 정책
| 이름 | 비고 |
|---|---|
| 신분-기반 정책 (DAC) | 개인 또는 그들이 속해 있는 그룹들의 신분에 근거하여 객체에 대한 접근을 제한하는 방법. IBP, GBP - 임의적 접근 통제는 사용자의 신원에 근거를 두고 권한을 부여하고 취소하는 메커니즘을 기반. Grant, Revoke |
| 규칙-기반 정책 (MAC) | 강제적 접근 통제와 동일한 개념, 주체가 갖는 권한에 근거하여 객체에 대한 접근을 제한. MLP, CBP - 강제적 접근 통제는 주체와 객체를 보안 등급 중 하나로 분류하고, 주체가 자신보다 보안 등급이 높은 객체를 읽거나 쓰는 것을 방지 |
| 역할-기반 정책 (RBAC) | GBP의 한 변형된 형태. 정보에 대한 사용자의 접근이 개별적인 신분이 아니라 개인의 직무 또는 직책에 의해 결정 |
- 접근통제 메커니즘
| 이름 | 비고 |
|---|---|
| 패스워드 | 데이터 및 프로그램 접근권한 확인 |
| 암호화 | |
| 접근통제목록(ACL) | 객체를 기준으로 접근 통제 정보를 저장. 어떤 사용자들이 객체에 대하여 어떤 행위를 할 수 있는지를 나타냄. 주체의 수가 많아지면 관리 어려움 |
| CL(Capability List) | ACL 문제해결. 주체가 접근할 수 있는 객체와 접근 권한을 주체에 저장하는 방식 |
| 보안등급 | 주체나 객체 등에 부여된 보안 속성의 집합 |
| 통합 정보 메커니즘 | 두가지 이상의 복합된 특성으로 구현 |
- 데이터베이스 서버 시작과 종료
- 데이터베이스 관리자가 DBMS 인스턴스를 시작
- 인스턴스 시작은 매개변수 파일을 읽음
- 초기화 매개변수
- 파일과 같은 항목에 이름을 지정
- 최대 값과 같은 한계를 설정
- 메모리 크기와 같은 용량에 영향을 주는 매개변수 (가변 매개변수)
- 인스턴스를 시작할 데이터베이스 이름
- 로그 파일의 처리 방법
- DB 제어 파일의 이름과 위치
- 초기화 매개변수
| 과정 | 비고 |
|---|---|
| 인스턴스 시작 | 매개변수 파일을 읽어 초기화 매개변수 값을 결정하고 프로세스를 구동 |
| DB 마운트 | 데이터베이스의 제어파일을 오픈 |
| DB 오픈 | 데이터파일, 로그파일을 오픈, 자동복구, 미확정 분산 트랜잭션 해결 |
| DB 닫기 | 메모리에 있는 모든 DB 데이터와 로그를 데이터 파일과 리두 로그 파일에 각각 기록하고 온라인 데이터 파일과 온라인 로그 파일을 닫음 |
| DB마운트 해제 | DB 마운트를 해제하여 DB와 인스턴스 간의 관계를 끊고 DB의 제어 파일을 닫음 |
| 인스턴스 종료 | 할당된 공유 영역이 메모리에서 제거되고 백그라운드 프로세스가 종료 |
데이터 블록
- DBMS는 데이터베이스의 모든 데이터에 대한 논리적 데이터베이스 영역을 할당
- DB영역의 할당 단위는 데이터 블록, 세그먼트, 확장영역
- 데이터 블록, 확장영역, 세그먼트 간의 관계
- 데이터 블록
- 데이터를 저장하는 가장 작은 단위
- 하나의 데이터 블록은 디스크상의 물리적 DB영역의 특정 바이트 수에 해당(2K, 4K, 8K) 테이블스페이스별로 사이즈 결정가능.
- 1회 물리적인 디스크 I/O량을 결정
- 데이터베이스의 용도(OLTP, DW)에 따라 적절한 사이즈 설정
- 데이터 블록 체인을 최소화
- 데이터블록의 구성
| 이름 | 비고 |
|---|---|
| Header | 블록 주소와 세그먼트 유형 등 블록정보 |
| Row directory | 램 데이터 영역에 있는 각 행 조각의 주소를 포함하여 블록에 있는 실제 행에 대한 정보 |
| Free space | 새로운 행을 삽입하거나 후행 null을 null이 아닌 값으로 갱신할 때와 같이 추가 영역이 필요한 행을 갱신할 때 할당 |
| Row data | 실제 데이터 저장 |
-
세그먼트 (SEGMENT)
- 테이블스페이스 내에 어떤 논리적인 구조를 정의하기 위해 할당한 확장 영역의 집합
- 테이블, 인덱스, 임시용 세그먼트가 지원
- 특정 테이블의 데이터 세그먼트를 형성
- 특정 테이블의 인덱스 세그먼트를 형성
- 테이블스페이스 내에 어떤 논리적인 구조를 정의하기 위해 할당한 확장 영역의 집합
-
데이터 확장 영역 (EXTENT)
- 특정 유형의 정보를 저장하기 위해 할당된 몇 개의 연속적인 데이터 블록
- 세그먼트가 공간을 더 필요로 할 때 추가로 할당받는 데이터 블록 묶음
- 데이터 블록의 초기 확장영역을 세그먼트에 할당, 할당된 데이터 블록이 모두 채워지면 새로운 확장영역을 자동 할당
- 저장공간 낭비를 줄이고 무한정 확장되는 것을 방지
- 데이터를 삭제하여도 확장된 영역을 반환하지 않음
- 생성된 객체를 Drop하거나 Truncate해야 테이블스페이스로 반환
“NULL 허용 컬럼은 무조건 뒤로”가 아니라, NULL 발생 빈도가 높은 컬럼을 가능한 뒤쪽에 배치하면 행 저장 공간을 줄일 수 있다.
- Oracle 기준으로는 맞는 설계 팁이다.
- 이유는 Oracle의 행 저장 방식 때문이다.
- Oracle은 행 내부에서 중간에 있는 NULL 컬럼은 1바이트의 길이 정보가 필요하지만,
- 행의 뒤쪽에 연속해서 위치한 trailing NULL들은 저장 공간을 사용하지 않는다.
결합 인덱스에서 컬럼의 순서는 항상 사용되는 컬럼 > 등치조건 > 분포도 > 정렬 순으로 정의된다.
- 변별이 낮은 컬럼은 col1=v1 의 조건을 full table scan 으로 유도하는 것이 유리하다.