- 데이터 모델링 표기법 이해
- 데이터 모델링 기법 이해
- 데이터 모델링 개요
- 데이터 모델링 이해
- 개념 데이터 모델링
- 개념 데이터 모델링 이해
- 주제 영역 정의
- 후보 엔티티 선정
- 핵심 엔티티 정의
- 관계 정의
- 개념 데이터 모델 작성
- 논리 데이터 모델링
- 논리 데이터 모델링 이해
- 속성 정의
- 엔티티 상세화
- 이력관리 정의
- 논리 데이터 모델 품질 검토
- 물리 데이터 모델링
- 물리 데이터 모델링 이해
- 물리 요소 조사 및 분석
- 논리-물리 모델 변환
- 반정규화
- 물리 데이터 모델 품질 검토
데이터 모델링
코드성 엔티티
부모 삭제 → 자식 CASCADE 삭제 : O
자식 마지막 건 삭제 → 부모 역방향 CASCADE 삭제 : X
| 용어 | 의미 | DAP 관점 |
|---|---|---|
| 식별자 | 엔터티의 각 인스턴스를 유일하게 식별하는 수단 | 한국어 표현 |
| UID | Unique Identifier | 식별자를 지칭하는 영문 표현 |
| PUID | Primary Unique Identifier | 여러 UID 중 주 식별자로 선택된 것 |
| 무결성 | 논리 모델링에서 | 물리 모델링에서 |
|---|---|---|
| 실체 무결성 | 주식별자 정의를 통해 논리적으로 반영 | PK, UNIQUE, NOT NULL 등으로 구현 |
| 영역(Domain) 무결성 | 속성/도메인의 의미·허용범위 등을 정의 | 데이터 타입, 길이, CHECK 등으로 구현 |
| 참조 무결성 | 입력/삭제 규칙 등을 명시적으로 정의 | FK 및 관련 Constraint로 구현 |
| 사용자 정의 무결성 | 업무 규칙으로 식별·정의 가능 | CHECK, Trigger, 프로그램 등으로 구현 |
| 개념 | 실행업무 |
|---|---|
| 개념 | 주제영역, 엔티티 (후보/핵심), 관계, 개념 DM |
| 논리 | 속성, 엔티티 (detail), 이력관리, 정규화, 참조 무결성 규칙 정의 |
| 물리 | 물리요소, DBMS, 반정규화, 무결성 규칙 구현 |
- 상위의 순서 주의. 동일 DMing 안에서도 순서를 탄다
- 모델링 기본원칙
- 커뮤니케이션 원칙
- 모든 사람들이 이해할 수 있도록 명확하게 공표됨은 물론 최종 사용자 지향적으로 분명하게 파악되는 수준으로 작성
- 논리데이터모델: 비즈니스 지향적인 최종 사용자 데이터 모델과 기술적인 상세 데이터 모델
- 데이터 모델의 이해를 필요로 하는 그룹
- 모델링 상세화 원칙
- 데이터의 상세화 정도를 제시하고 조직이 사용하는 정보 구조의 ‘최소 공통 분모’를 제시
- 복잡한 구조는 요소적인 부분들로 쪼개야 하며 불필요한 구조와 중복은 제거
- 논리적 표현 원칙
- 조직의 데이터에 대한 논리적 측면을 최대한 표현
- 모델은 물리적 제약 조건 없이 비즈니스를 그대로 반영
- 커뮤니케이션 원칙
# 데이터 모델의 이해를 필요로 하는 그룹

최종사용자
	- 개념화, 추상화, 정규화 기법을 통하여 중복없고 데이터의 정확성을 보장하는 데이터 구조의 이해 및 사용
시스템분석가
	- 시스템에서 사용되어질 정확한 데이터의 구조 및 데이터가 갖는 업무 규칙의 이해
DBA
	- 논리 데이터 모델의 구조와 물리 스키마의 차이점을 이해하고 최종 사용자에게는 데이터의 제공,
	  시스템 분석가에게는 물리 스키마의 제공을 위한 데이터 구조의 이해
타프로젝트 분석가
	- 관련 프로젝트가 데이터를 어떻게 정의하고 있는지를 알아냄.
	  인터페이스가 개발되어지고 데이터가 애플리케이션 또는 시스템 간에 공유되기 위한 데이터 구조 및 업무 규칙의 이해
- 식별자 앞에는 # 기호를 표시하고 여러개 # 기호를 반복적으로 표시
- 식별자의 유형
| 구분 | 관계형 | 비관계형 |
|---|---|---|
| 구조 | 6가지 특성 갖는 테이블 | Flat File |
| Post Define Schema | Pre define Schema | |
| DB구조변경 용이 | DB구조변경 어려움 | |
| 조작 | 8개 조회/처리 연산자 | READ조회, 처리연산자 |
| 집합(SET)처리 | 한건씩 처리 | |
| 원자값 처리 | Pointer 처리 | |
| 무결성 | 엔터티,참조,무결정,연쇄작용 | 무결성 개념 없음 |
| 접근경로 | Key와 인덱스 별개 | Key와 인덱스 동일 |
| Data에 대한 접근경로 유연 | Data에 대한 접근경로 제한적 |
- 관계형 모델 이론
- 데이터 구조: 사용자가 인식하는 데이터의 구성
- 데이터 조작: 사용자가 관계형 데이터 구조에 행하는일련의 연산(처리)형태
- 데이터 무결성: 사용자가 일련의 관계형 연산을 수행할때 테이블의 데이터 값이 어떻게 되야 하는지를 통제하는 일련의 업무 규칙
- 데이터 무결성
- 사용자가 일련의 관계형 처리(입력, 수정, 삭제, 조회)를 수행할 때 관계형 엔터티의 데이터값이 어떻게 작용해야 하는지 통제하는 일련의 업무규칙
- 실체 무결성 (엔터티 무결성)
- 두 개의 똑같은 튜플은 한 릴레이션에 포함불가 (유일식별자)
- 식별자를 구성하는 각 속성이 NOT NULL
- 엔터티 내 특정 인스턴스의 유일성 보장
- 최소한의 속성 집합
- 참조무결성
- 데이터가 하나 또는 두 개의 관계있는 엔터티에 입력, 수정, 삭제될 때 데이터가 어떻게 반응해야 하는가에 대한 업무 규칙
- 엔터티의 주키와 마찬가지로 외래키도 데이터 무결성에 관한 규칙을 내포
- 참조무결성규칙: 엔터티의 모든 외래키 값은 관계 있는 엔터티에 주 키 값으로 존재해야함
- DB설계관점에서 선택하지 말고, 현업의 업무규칙에 따라 적절한 규칙을 선택.
- 입력규칙: 자식 엔터티의 행이 입력될때
- 삭제규칙: 부모 엔터티의 행을 삭제할때 (또는 행의 주키를 수정할때)
- 도메인 무결성 (길이, 허용값, 범위)
- 데이터 타입, 길이, 허용값, 기본값, 유일성, 널 여부 등에 관한 업무규칙
- 도메인: 속성이 가질 수 있는 값의 전체 집합
- 같은 도메인의 값들끼리만 비교 가능
- 속성이 취할 수 있는 값의 제한
- 연쇄작용 또는 업무규칙
- 연쇄작용: 입력,수정,삭제 또는 조회 등의 작업이 동일 엔터티 혹은 다른 엔터티의 속성에 영향을 미치는 업무 규칙
- 업무규칙은 조직이 데이터를 인식하고 사용하는 방법에 기초
확장된 ER모델 (개체-관계 모델) 은 서브타입을 포함한다.
| 분류 | 이름 | 비고 |
|---|---|---|
| 집합 (SET) 처리 | ||
| 관계연산자 (조회) | Select (or Restrict) | 열에 의거한 행의 부분집합 |
| Project (π) | 열의 부분집합(subset) | |
| Product (×) | 두 관계 테이블간 행의 조합을 묶음 | |
| Join (⨝) | 열의 기준에 의거하여 각 행을 수평적으로 묶음 | |
| Union (∪) | 중복없이 각 행을 수직적으로 묶음(합집합) | |
| Intersection (∩) | 관계 테이블간의 공통된 행(교집합), 테이블 구조는 동일 | |
| Difference (- 또는 제외) | 하나의 관계 테이블에만 있는 행(차집합), intersection의 반대 | |
| Division (¼) | 다른 관계 테이블의 모든 행에 대응하는 열을 제외한 열. (R에서 S의 레코드를 다가진 레코드) | |
| 처리연산자 (테이블 내용 변경) | Insert | 행의 삽입 |
| Update | 행의 수정 | |
| Delete | 행의 삭제 |
- 본질적 데이터 요구사항
- 이름
- 모든 속성은 고유하게 식별할 수 있는 이름이 주어져야함
- 명세 (Description)
- 모든 실체는 명세가 있어야 함.
- 모형을 검토하는 누구든지 실체를 정확히 해석할 수 있어야 함.
- 유형 (Type)
- 속성은 Key 속성 또는 Non-Key 속성중 하나로 구분되어야 함.
- 이 특성은 key 속성으로써의 역할 가능성보다는 실제 용도와 관련된다
- 이름
- 좋은 데이터 모델의 요소 (완중업재 안의간통)
| 이름 | 비고 |
|---|---|
| 완전성 | 업무에서 필요로 하는 모든 데이터가 데이터 모델에 정의 |
| 중복배제 | 하나의 DB내에 동일한 사실은 반드시 한번만 기록 |
| 비즈니스 룰 (업무규칙) | 수많은 업무 규칙을 데이터 모델에 표현하고 이를 해당 데이터 모델을 활용 하는 모든 사용자가 그 규칙을 공유하도록 제공 |
| 데이터 재사용 | 데이터의 통합성과 독립성에 대해서 충분히 고려. 통합모델을 구축하고, 애플리케이션에 대해 독립적으로 설계 |
| 안정성 및 확장성 | - 현재의 데이터 구조를 거의 변화하지 않고도 변화에 대응할 수 있는 데이터 구조 - 아주 적은 확장을 통해 이러한 변화에 대응 - 정보시스템에서의 ‘행위의 주체’가 되는 집합의 통합,‘행위의 대상’이 되는 집합의 통합, ‘행위 자체’에 대한 통합 |
| 의사소통 | 많은 업무 규칙은 해당 정보시스템을 운용/관리하는 많은 관련자들이 설계자가 정의한 업무규칙들을 동일한 의미로 받아들이고 정보시스템을 활용 |
| 간결성 | 데이터를 합리적으로 균형있고 단순하게 분류 |
| 통합성 | 조직의 전체에서 한 번만 정의되고 이를 여러 다른 영역에서 참조 |
데이터 모델링 기법 이해
- 데이터 모델 목적
- DB 설계에 대한 계획 또는 청사진
- 데이터 모델링 단계에서 업무를 잘못 이해했거나 관계를 잘못 정의한 것이 발견되었다면 해당하는 다이어그램과 일부 관련된 문서만 변경하면 됨.
- DB와 응용 프로그램 개발이 완료된 후 이러한 오류를 발견하여 수정하려면 이와 관련된 많은 프로그램과 SQL문이 변경되어야 함
- 뿐만 아니라 데이터가 새로운 구조로 옮겨져야 하는 등 이러한 변경을 반영하는 데 많은 비용과 시간이 필요하게 됨
- 개체-관계 모델 기법
- 데이터에 대해 관리자, 사용자, 개발자들이 서로 다르게 인식하고 있는 뷰들을 하나로 통합할 수 있는 단일화된 설계안
- 서로 다른 뷰를 충족시킬 수 있는 데이터 처리와 제약 조건 등의 요구 사항을 정의
- 구성요소
| 이름 | 비고 |
|---|---|
| entity | 업무 활동상 지속적인 관심을 가지고 있어야 하는 대상으로서, 그 대상들 간에 동질성을 지닌 것으로 볼 수 있는 개체 집합이나 그들이 행하는 행위의 집합 |
| 속성 | - 엔터티에 저장되는 개체 집합의 특성을 설명하는 항목 - 실체내에서 관리하고자 하는 정보들의 항목 - 도메인: 속성이 가질 수 있는 값의 범위 - 단일치 속성: 하나의 값만 존재 - 다중치 속성: 여러개의 값이 존재 |
| 식별자 | - 엔터티의 각 개체들은 인스턴스 - 인스턴스는 그들을 지칭하거나 식별해 주는 속성인 식별자를 가짐 - 복합 식별자: 두 개 이상의 속성으로 이루어진 식별자 |
| 관계 (식선카비) | - 엔터티와 엔터티 간 연관성을 표현 - 하나 또는 두 개의 실체를 연관시키는 업무와 관련된 중요한 사항. - 식별성, 선택성, 기수성, 비전이성 - 매핑 카디날리티는 ERD에서 개체와 연결될 때 나타나는 대응되는 수 - 대응수, 최대대응수, 최소대응수로 구분 |
| 카디날리티 (기수성) | - 한 개체가 관계를 통하여 다른 개체와 관련된 개체들의 수(관계에 참여하는 엔터티의 개수) - 1:1, 1:M, M:M |
| 존재종속 | - 한 엔터티의 존재가 다른 엔터티(들)의 존재에 영향을 받는 경우 - 전체참여, 부분참여 |
| 서브타입 | - 엔터티의 하위 집합 (부분집합). 속성을 상속함 - ex) 학생(슈퍼) > 학부학생, 대학원생(서브) - 배타적: 슈퍼타입은 많아야 1개의 서브타입과 관련. (돔안에 X표시) - 포괄적: 슈퍼타입은 1개 또는 그 이상의 서브타입과 관련 - 모든 슈퍼타입이 구분자를 가지고 있는 것은 아님. - 서브타입은 그것의 슈퍼타입이라 불리는 다른 개체의 특별한 경우 |
| 특성 | 의미 | 핵심 질문 |
|---|---|---|
| 식별성 (Identification) | 부모와의 관계가 자식의 식별자 구성에 참여하는지 | 부모 식별자를 자식 PK로 물려받는가? 부모가 내 식별자에 들어오는가 |
| 선택성 (Optionality) | 관계 참여가 필수인지 선택인지 | 반드시 관계를 가져야 하나? 상대가 반드시 있어야 하는가 |
| 기수성 (Cardinality) | 상대 엔터티의 인스턴스와 몇 개까지 관계를 맺는지 | 1개인가, 여러 개인가? 상대가 몇개까지 가능한가 |
| 비전이성 (Non-transferability) | 한 번 맺어진 관계를 다른 부모 인스턴스로 이전할 수 없는지 | 부모를 다른 인스턴스로 바꿀 수 있는가? 한번 정한 상대를 다른 인스턴스로 바꿀 수 없는가 |
- 객체지향 모델링
- 객체지향 방법론-객체지향 분석-객체지향 설계-객체지향 모델링-객체지향 프로그래밍-객체지향 DBMS
- 데이터와 프로세스를 같은 객체 안에 결합한다
- 객체지향 개념
- 객체는 속성과 메소드로 구성.
- 속성은 객체 클래스의 성질.
- 메소드는 하나 이상의 속성을 접근, 조작, 수정, 삭제, 생성하는 프로세스
- 연관 또는 상속을 통해서 다른 객체들에 연결
- 연관은 객체 간의 자연적 관계
- 객체는 속성과 메소드로 구성.
- 객체 모형
- 주제에 연관된 기본 객체 식별, 객체간의 연관을 식별
- 객체 모형 데이터
- 객체-관계 다이어그램에 모형화
- 불명료한 객체 접근 방식
- 객체지향 개발의 가장 단순화된 표현: 객체지향 개발을 분명하게 이해하는데 필요한 많은 객체지향 특징을 무시하는 것
- 객체지향 모델링의 미성숙: 객체가 어떻게 표현되고 기호가 어떻게 사용되어야 하는가 등의 정의는 아직까지 초기단계.-
- 객체지향 모델링 장점
- 재사용 코드, 모든 비즈니스 규칙 표현, 프로세스와 데이터 모델링을 함께 운영
- 객체가 다른 객체와 연결되는 방법은 연관 또는 상속
- 객체 모형의 메소드
| 분류 | 비고 |
|---|---|
| 단순한 메소드 | 설명부 또는 구조화된 기법 사용 |
| 복잡한 메소드 | 정교한 문서화 접근 방식이 필요 |
| 이벤트 지향적인 프로세스 | 상태 전이 모델링과 같은 동적 프로세스 모델링 기법이 필요 |
| 정적인 프로세스 | 데이터 흐름 다이어그램이나 기능 분해와 같은 기법을 사용 |
- 객체지향 모델링과 논리 데이터 모델링간의 관계
| E-R | OO |
|---|---|
| 엔티티 | 객체 |
| 속성 | 속성 |
| 관계 | 연결 |
| 엔티티 유형 | 객체 클래스 |

개념 데이터 모델
-
주제영역 개념
- 기업이 사용하는 데이터의 최상위 집합
- ex) 제조의 경우, 인사/생산/자재/판매
- 시스템의 대상이 되는 업무를 명백하게 구분이 가능한 단위업무로 분리하는 개념
- 주제영역 내부에 존재하게될 개체들이 높은 결합성을 유지하게 해야함
- 프로세스 모델링의 기능 (function) 과 매핑
- 기업이 사용하는 데이터의 최상위 집합
-
속성 검증 및 확정 로직
- 원자단위 (최소단위까지 분할)
- 집합 개념의 속성은 단순 개념으로 분할
- 가능한 최소 단위까지 분할한 후 관리 필요에 따라 통합
- 일자, 시간, 성명, 주민등록번호, 우편번호 등은 일반적으로 분할하지 않음
- 분할 및 통합의 기준은 업무의 요구 사항에 따름
- 유일값
- 여러 값을 가지거나 반복되는 속성은 잘못된 속성
- 반복되는 속성은 새로운 엔터티로 분할해야 할 1차 정규화의 대상임
- 가공값 (추출 속성인지 검증)
- 속성이 원천적인 값인지, 다른 속성에 의해 가공되어서 만들어진 값인지를 검증
- 원천값에서 다시 계산 가능한 값을 별도로 저장하면 원천값 변경 시 가공값과 불일치할 수 있음
- 가공값이라면 어떤 원천 속성에서 어떤 규칙으로 만들어지는지 명확히 해야 함 (산출 근거를 모델에 표현)
- 업무상 중요한 가공정보를 누락하지 않기 위해
- 관리수준 상세화 검토
- 더 상세한 정보관리가 필요한지 검토
- 원자단위 (최소단위까지 분할)
인덱스 = 기본적으로 성능 구조
Constraint = 기본적으로 무결성 구조
- 엔터티 검증
- 조직의 업무를 수행하는데 필요한 의미있는 정보를 나타내야 함
- 특정 사례가 아닌 유사한 사물들을 대표하는 집합체 (구매부서 > 부서)
- 인스턴스가 포함할 내부 연관성 있는 속성에 의해 결정된 단일개념을 대표해야함
- 엔터티내 인스턴스의 출현을 구별할 수 있는 능력을 제공해야 함 (엔터티 무결성)
- 정규화 규칙을 만족해야함
후보 엔터티 선정
-
엔터티 정의
- 엔터티의 개념 정의에 적합한 대상을 찾아 후보 검증을 거쳐 엔터티로서 확정
- 데이터 집합으로서 해당 엔터티의 성격을 규명하는 것.
- 엔터티 후보 선정>엔터티 형태별 분류>엔터티 자격 검증>엔터티 형태 결정>본질식별자 확정>엔터티 정의서 작성
-
엔터티 후보 수집
- 기존 시스템 도큐먼트, 현업 장표/보고서, 현업 인터뷰, 관련 전문 서적, 데이터 흐름도, 타시스템 자료, 현장 조사
-
유의사항
- 엔터티 가능성이 있다고 예상되면 일단 검토 대상에 올려라
- 너무 깊게 들어가지 마라
- 동의어처럼 보이더라도 함부로 버리지 마라
- 개념이 모호한 대상은 일차로 그 개념을 상식화하여 이해
- 프로세스에 너무 연연해 하지마라
- 예외 경우에 너무 집착하지마라
- 단어 하나하나에 집중해서 판단
- 후보를 선정했으면 핵심적인 특징 파악
- 사용자에게 의존말고 자신의 이해를 바탕
- 구현할 시스템의 업의 본질 염두
-
후보 식별
- 엔터티 후보의 개념 정립
- 관리 대상 판정
- 집합 여부 확인
- 검토 대상이 집합이 되는지 확인 (가로와 세로가 각각 2개이상인가)
- 가로는 속성, 세로는 개체 (인스턴스:구체화한 대상)
- 수집된 엔터티 분류
- 개체집합, 행위집합
-
우선 적용 대상 분류
- 키 엔터티
- 자신의 부모를 가지지 않는 엔터티
- ex) 사원, 부서, 고객, 상품, 자재
- 메인 엔터티
- 키 엔터티를 제외한 다른 모든 엔터티는 부모 엔터티를 가지고 있어야만 태어남
- 업무의 중심에 해당하는 엔터티를 메인 엔터티라 정의하고, 나머지를 액션 엔터티로 정의
- ex) 주문, 예산편성, 매출
- 액션 엔터티
- 키엔터티와 메인엔터티가 아닌 엔터티. 수행된 업무를 포함
- ex) 상태 이력, 차량 수리 내역, 상세 주문 내역
- 키 엔터티
-
데이터 영역별 분류
- 데이터 영역을 정의하는 방법은 접근 방법별로 볼 때 크게
- 하향식과 상향식 접근 방법
- 데이터 영역을 정의하는 방법은 접근 방법별로 볼 때 크게
개념 모델링 → 수평적으로 핵심 엔터티와 관계를 먼저 파악
특정 엔터티에서 하위 엔터티로 계속 파고들기 → 수평적 사고 저해 → 부적절
관계 정의
- 관계
- 두 엔터티 간에 존재하는 업무적 연관성을 표현하는 것
- 관계 표현을 통해 업무 규칙을 정의
- 관계 특성
-
관계 is 집합, 관계 is 속성
- 두 엔터티 사이에 그 목적과 내용이 다른 여러 개의 관계가 동시에 존재 가능
- 릴레이션 엔터티, 교차 엔터티, 제휴 엔터티
-
직접 관계를 관계라고 함
- 직접 종속인 것만 관계로 봄
-
두 엔터티 간에는 하나 이상의 관계 존재 가능
-
외래키로 정의
- 관계는 외래키로 구현되어 참조무결성으로 데이터 정합성을 유지
-
관계의 관점
- 항상 두 엔터티 간에 존재
- 항상 두개의 관점을 가짐
- 데이터의 양방향 업무 규칙을 표현
- 관계를 통하여 정보로서의 활용가치 상승
-
| 명칭 | 영어 | 의미 | 서로의 관계 |
|---|---|---|---|
| 릴레이션 엔터티 | Relation Entity | 관계가 엔터티로 변환되었다는 점을 강조 | 기준 명칭 |
| 교차 엔터티 | Intersection Entity | 두 엔터티의 M:N 교차 지점이라는 점을 강조 | 릴레이션 엔터티와 동일 |
| 제휴 엔터티 | Association Entity | 두 엔터티를 연결/제휴한다는 점을 강조 | 릴레이션 엔터티와 동일 |
-
관계 표현
- 식별성, 선택성, 기수성
-
관계 형태
- 하나 이상(many)
- 하나 이상인 것이 적어도 한가지는 존재
- 까마귀발가락 모양
- 단 하나(only one)
- 단 하나임, 수평선
- 하나 이상(many)
-
선택사양
- 직선은 반드시 존재해야 함을 의미(필수)
- 점선은 존재하지 않을 수도 있음(옵션)
- 일반적인 형태
- 주로 참조하는 엔터티(M쪽)는 참조되는 엔터티(1쪽)가 반드시 존재해야 하는 경우
- 반대로 1쪽 엔터티는 M쪽 엔터티와 반드시 관계를 맺지 않아도 되는 경우
- 바람직한 형태
- M쪽(자식) 관계의 선택사양을 직선관계로 만들려고 노력
-
관계명
- 두 개의 관계 멤버십에 각각 부여
- 현업에서 사용하는 간결한 동사형으로 표현
- 업무적 의미가 없거나 애매모호한 용어는 배제
- 두 엔터티 타입 간의 업무적 연관성을 나타내는 이름 부여
- 현재 시제를 사용
- 다른 관계명과의 유일성은 확보되지 못함
- 능동/수동형의 사용은 가급적 배제
-
관계 정의 방법
- 한쪽 엔터티를 기준으로 상대 엔터티와의 관계를 규명하고 다시 반대 방향으로 관계를 규명
-
관계구문 이해
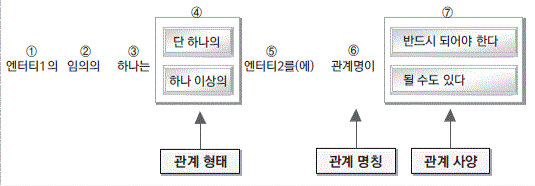
- 다중 관계 처리
- 다중 관계란 어떤 두 엔터티의 사이에 하나 이상의 관계를 가지고 있는 상태
- 여러 개의 관계로 나누어 관리하는 것을 병렬식이라고 하고, 하나로 묶어서 관리하는 것을 직렬식 관계라고 함
- 병렬식 관계
- 두 엔터티 사이에 존재하는 관계들을 별도의 관계로 간주
- 테이블이 될 때 여러 개의 컬럼으로 나열
- 하나의 행(ROW)에서 관리되므로 새로운 테이블을 추가할 필요가 없음
- 인덱스 수가 증가되고 SQL이 복잡해짐
- 새로운 관계의 추가, 관계 형태의 변경 등에 매우 취약한 형태
- 관계 내용별로 상세 정보를 관리 불가
- 직렬식 관계
- 두 엔터티 사이에 존재하는 몇 개의 관계를 모아 상위 개념으로 통합함으로써 하나의 관계로 관리하는 방법
- 관계들을 관리하는 새로운 엔터티가 추가
- 관계들이 행(ROWS) 형태로 나타남
- 인덱스 수가 감소하고 SQL이 단순해짐
- 새로운 관계의 추가, 관계 형태의 변경 등에 매우 유연한 형태
- 관계 내용별로 상세 정보를 관리가능
- 관계 내용별로 자식 엔터티를 가질 수 있음.
| 구분 | 병렬식 관계 | 직렬식 관계 |
|---|---|---|
| 기본 개념 | 두 엔터티 사이의 여러 관계를 각각 별도 관계로 관리 | 여러 관계를 상위 개념으로 통합하여 하나의 관계로 관리 |
| 물리 구현 형태 | 관계별로 여러 컬럼으로 표현 | 관계 관리용 별도 엔터티/테이블 추가 |
| 데이터 표현 | 하나의 ROW 안에 여러 컬럼으로 관계 표현 | 관계별로 여러 ROW로 표현 |
| 추가 테이블 | 불필요 | 필요 |
| 인덱스 수 | 증가 가능성이 큼 | 상대적으로 감소 |
| SQL 복잡도 | 관계별 컬럼을 처리해야 해서 복잡해짐 | 통합된 구조로 처리하므로 상대적으로 단순 |
| 새로운 관계 추가 | 취약 — 컬럼 추가, 모델 변경 필요 가능 | 유연 — 새로운 ROW/관계유형 추가로 대응 가능 |
| 관계 형태 변경 | 취약 | 유연 |
| 관계별 상세정보 관리 | 어려움 | 가능 |
| 관계별 자식 엔터티 관리 | 어려움 | 가능 |
| 장점 | 구조가 단순하고 별도 엔터티가 필요 없음 | 확장성·유연성이 높고 관계별 속성 관리 가능 |
| 단점 | 확장성 낮음, 인덱스 증가, SQL 복잡 | 엔터티/테이블이 추가되어 구조가 한 단계 복잡해짐 |
[병렬식]

사원
- 사원번호
- 정관리자번호
- 부관리자번호
- 승인자번호
[직렬식]

사원
- 사원번호

사원관계
- 사원번호
- 관계유형       ← 정관리자 / 부관리자 / 승인자
- 상대사원번호
- 관계시작일
- 관계종료일
병렬식 = 관계가 컬럼으로 증가 → 단순하지만 변화에 취약 직렬식 = 관계가 ROW로 증가 → 별도 엔터티 필요하지만 변화에 유연
그리고 관계별 추가 속성이 필요하다, 관계 유형이 자주 추가된다 같은 조건이 나오면 직렬식 관계가 유리하다.
| 개념 | 테이블에서 대응 |
|---|---|
| 엔터티(Entity) | 테이블 전체에 대응 |
| 속성(Attribute) | **컬럼(Column)**에 대응 |
| 인스턴스(Instance) | **행(Row)**에 대응 |
| 관계(Relationship) | 보통 FK 컬럼 또는 관계 테이블로 구현 |
엔터티   ↔ 테이블
속성     ↔ 컬럼
인스턴스 ↔ Row
관계     ↔ FK 또는 별도 관계 테이블
사원 테이블
-------------------------
사원번호 | 이름 | 부서번호
1001     | 김A  | D01
1002     | 이B  | D02
여기서:
사원 → 엔터티 사원번호, 이름, 부서번호 → 속성 1001 / 김A / D01 한 줄 → 사원 인스턴스 하나 부서번호 → 부서 엔터티와의 관계를 구현하는 FK
그래서 네 질문에 직접 답하면:
컬럼 1개 = 관계 1개 → X 컬럼은 기본적으로 속성이다. 다만 FK 컬럼이면 관계를 구현할 수 있다.
Row 1개 = 엔터티 1개 → X Row 1개는 엔터티의 인스턴스 1개다.
그리고 아까 병렬식/직렬식 관계 설명에서 “관계가 컬럼으로 나타난다”는 것은 관계 자체가 컬럼이라는 뜻이 아니라, 각 관계를 구현하는 FK 컬럼이 여러 개 생긴다는 뜻이다.
사원
- 사원번호
- 정관리자번호 FK
- 부관리자번호 FK
- 승인자번호 FK
여기서는 사원-사원 사이에 3개의 관계가 있고, 그 3개의 관계가 각각 FK 컬럼으로 구현된 것이다.
- M:M 관계 해소
- M:M 관계는 최종적으로 완성된 데이터 모델에는 존재할 수 없는 형태
- M:M 릴레이션십은 새로운 릴레이션 엔터티를 추가하여 M:1 관계로 변경
- 즉시1:M 관계 엔터티로 분해해야 하는 경우
- 자식을 가져야 하는 경우
- 추가적인 속성을 가져야 하는 경우
- 이외에는 논리모델링 상세화 단계에서 해소
- 특수한 형태 관계
- 순환 관계
- 하나의 엔터티가 자기 자신과 관계를 맺는 관계
- 하나의 순환 엔터티는 각 엔터티의 모든 속성을 포함
- 각 계층에 있는 속성은 동일하게 함
- 순환 모델은 필수(직선) 관계로 취급될 수 없고(무한 LOOP 발생), 반드시 선택사양 관계
- 조직의 변경(추가/삭제)에 쉽게 대응
- BOM 관계 (BILL OF Materials)
- BOM 관계의 모델을 네트워크 구조 (전철 노선이나 하이퍼링크를 갖는 웹 도큐먼트 같은)
- M:M 순환구조: 상세 모델링 과정에서 새로운 관계 엔터티를 추가하여 두 개의 일대다(1:M) 관계로 구성된 모델로 구체화
- ARC 관계 (Mutally Exclusive)
- 어떤 엔터티가 두 개 이상의 다른 엔터티의 합집합과 관계를 가지는 것을 배타적(Exclusive) 관계 혹은 아크(Arc) 관계라 함
- 아크 내에 있는 관계는 보통 동일
- 아크 내에 있는 관계는 항상 필수이거나 선택
- 아크는 반드시 하나의 엔터티에만 속해야 함 (하나의 아크가 여러 엔터티를 가질 수 없음)
- 어떤 엔터티는 다수의 아크를 가질 수 있음. 지정된 관계는 단 하나의 아크에만 사용되어야 함
- 논리적으로 엔터티간의 업무적 연관성을 명확하게 표현
- 실제 DB로 구현시 엔터티를 하나로 통합할 수도 있음.
- 순환 관계
| 구분 | 핵심 의미 | 대표 구조 |
|---|---|---|
| 순환 관계 | 엔티티가 자기 자신과 관계 | 1:M 자기참조 |
| BOM 관계 | 자기 자신과의 M:M 순환 관계 | 관계 엔티티로 해소 |
| ARC 관계 | 여러 부모 중 하나와만 배타적으로 관계 | Mutually Exclusive |
| 순환 | BOM | ARC |
|---|---|---|
 |  |  |
논리 데이터 모델
3. 엔터티 상세화
1. 식별자 확정
본질 식별자 = “나를 누구/무엇이 태어나게 했는가?”
실질·인조 식별자 = “태어난 나를 실제 시스템에서 무슨 값으로 부를 것인가?”
| 단계 | 핵심 내용 |
|---|---|
| 1. 본질 식별자 도출 | 해당 엔터티가 본질적으로 어떤 식별자를 가져야 하는지 파악 |
| 2. 후보 식별자 도출 | 실제로 인스턴스를 유일하게 구분할 수 있는 식별자 후보 선정 |
| 3. 대체(보조) 식별자 검토 | 본질 식별자 외에 동일한 식별 기능을 수행할 수 있는 식별자 파악 |
| 4. 인조 식별자 지정 | 본질 식별자를 실제 식별자로 쓰기 곤란할 때 인위적 식별자 생성 |
| 5. 식별자 확정 | 키 → 메인 → 하위 엔터티 순으로 최종 식별자 결정 |
- 키 엔터티의 본질 식별자
- 키 엔터티는 다른 엔터티에 의존해서 태어나는 것이 아니라 자체적으로 존재하는 엔터티
- 따라서 엔터티 자체의 업무적 속성에서 본질 식별자를 찾는다
- ex) 고객 → 고객을 업무적으로 식별하는 정보
- ex) 상품 → 상품을 식별하는 정보
- 행위 엔터티의 본질 식별자
- 부모 엔터티와의 관계를 분석해서 본질 식별자를 찾는다
- ‘절대종속이면서 직접종속인 부모의 식별자’ 를 중심으로 확인
- 자신을 발생시킨 직접적인 근본 원인을 탐색
- ex) 주문이 없으면 주문상품 발생 불가 → 주문에 절대종속
- ex) 상품이 없으면 주문상품 발생 불가 → 상품에 절대종속
- ex) 주문상품이 주문, 상품과 직접 관계 → 직접종속
- 부모 엔터티와의 관계를 분석해서 본질 식별자를 찾는다
| 구분 | 의미 |
|---|---|
| 절대종속 | 부모가 존재하지 않으면 해당 엔터티의 인스턴스 자체가 발생할 수 없음 |
| 상대종속 | 해당 부모가 없어도 엔터티의 인스턴스 발생 자체는 가능 |
| 직접종속 | 해당 부모와 직접 관계를 맺고 있음 |
| 간접종속 | 다른 엔터티를 거쳐 간접적으로 종속됨 |
- 후보 식별자 조건
- 현재 데이터에서 우연히 중복이 없다는 것
- 업무적으로 유일하다는 것을 구분
| 조건 | 의미 |
|---|---|
| 유일성 | 모든 인스턴스를 유일하게 식별해야 함 |
| 직접 식별 | 다른 속성들을 직접 식별할 수 있어야 함 |
| NOT NULL | 식별자 값이 반드시 존재해야 함 |
| 개념적 유일성 | 현재 데이터뿐 아니라 업무적으로도 유일해야 함 |
| 안정성 | 값이 자주 변경되지 않아야 함 |
-
대체 식별자 (보조 식별자)
- 본질 식별자를 대신해서 인스턴스를 식별할 수 있는 또 다른 속성 또는 관계의 집합
- 하나의 엔터티에 식별 가능한 방법이 여러 개 존재할 수 있다.
- ex) 사원번호 → 식별 가능
- ex) 주민등록번호 → 식별 가능
- 이라면 하나가 주 식별자로 선정되고, 다른 하나는 대체 식별자 또는 보조 식별자 역할
- 핵심은, 본질 식별자와 별도로 유일성을 보장할 수 있는 또 다른 식별 수단
- 본질 식별자를 대신해서 인스턴스를 식별할 수 있는 또 다른 속성 또는 관계의 집합
-
인조식별자 지정
- 본질 식별자가 존재하더라도 이를 그대로 실질 식별자로 사용하는 것이 부적절한 경우가 있다.
- 이때 본질 식별자의 전부 또는 일부를 임의의 값을 갖는 새로운 속성으로 대체한 것이 인조 식별자
주문번호 + 상품번호 + 주문순번 (본질)
     ↓
주문상세ID (인조)
| 기준 | 의미 |
|---|---|
| 범용적 값 사용 | 특정 업무 의미에 지나치게 종속되지 않는 값 사용 |
| 유일성 확보 | 유일한 값을 생성하기 위한 목적으로 사용 |
| 단일 속성 대체 가능성 검토 | 복합 식별자를 무조건 하나의 인조키로 바꾸는 것은 주의 |
| 편의성·단순성 | 복잡한 식별자를 단순화할 필요가 있을 때 사용 가능 |
| 의미 체계화 | 식별체계를 일관성 있게 만들 필요가 있을 때 사용 가능 |
| 내부 사용 | 시스템 내부 처리를 목적으로 사용할 수 있음 |
- 식별자 확정
- 순서가 존재한다.
- 상위 엔터티부터 식별자가 확정되어야 하위 엔터티가 UID를 상속받을지 여부를 결정할 수 있기 때문
- UID BAR
- 식별자에 포함됨을 나타내는 BAR
- 관계선을 통해 전달된 식별자가 해당 엔터티의 UID에 포함되는지를 나타내는 표현
- 부모 식별자가 자식에게 내려왔을 때
- 단순히 FK 역할만 하는 것이 아니라
- 경우에 따라서는 자식 식별자의 구성요소가 된다
- UID 상속과 단절
- 식별자 상속
- 순서가 존재한다.
# UID 상속

주문
PK 주문번호
↓
주문상품
PK 주문번호 + 상품번호
# UID 단절

주문상품
PK 주문상품ID
FK 주문번호
FK 상품번호
| 의미 | 설명 | |
|---|---|---|
| UID BAR | 식별자로서의 역할 | 부모 UID를 자식 UID의 일부로 사용 |
| 정보로서의 역할 | 부모와의 관계를 나타내는 정보 역할 |
키 엔터티 식별자 확정
        ↓
메인 엔터티 식별자 확정
        ↓
하위 엔터티 식별자 확정
4. 참조무결성 규칙 정의
| 구분 | 의미 |
|---|---|
| 입력 규칙 | 자식 엔터티에 데이터를 넣을 때 대응되는 부모가 어떻게 존재해야 하는지 규정 |
| 삭제 규칙 | 부모 엔터티를 삭제할 때 관련 자식을 어떻게 처리할지 규정 |
| 기반 | 부모 PK ↔ 자식 FK의 참조 관계 |
| DAP 위치 | 논리 데이터 모델링 → 관계 정의 → 참조 무결성 규칙 정의 |
- 참조무결성 규칙 정의
- 관계 테이블의 모든 외부 식별자 값은 관련 있는 관계 테이블의 모든 주 식별자 값이 존재
- 실체의 주 식별자(PK)와 마찬가지로 외부 식별자(FK)도 데이터 무결성에 관한 업무 규칙을 내포함
- 데이터베이스 설계 관점에서 선택하지 말고, 사용자의 업무 규칙에 따라 적절한 규칙을 선택
| 입력규칙 | 삭제규칙 | |
|---|---|---|
| 자식 엔터티의 인스턴스를 입력할 때 | 부모 엔터티의 인스턴스를 삭제 또는 주식별자를 수정할 때 | |
| DEPENDENT | 대응되는 부모 실체에 인스턴스가 있는 경우에만 자식 실체에 입력을 허용 | |
| AUTOMATIC | 자식 실체 인스턴스의 입력을 항상 허용하고, 대응되는 부모 건이 없는 경우 이를 자동 생성 | |
| RESTRICT | 대응되는 자식 실체의 인스턴스가 없는 경우에만 부모 실체 인스턴스 삭제를 허용 | |
| CASCADE | 부모 실체 인스턴스의 삭제를 항상 허용하고, 대응되는 자식 실체의 인스턴스를 자동 삭제 | |
| NULLIFY | 자식 실체 인스턴스의 입력을 항상 허용하고, 대응되는 부모 건이 없는 경우 자식 실체의 참조키 (FK)를 Null 값으로 처리 | 부모 실체 인스턴스의 삭제를 항상 허용하고, 대응되는 자식 실체의 인스턴스가 존재하면, 그것의 참조키(FK)를 Null 값으로 수정 |
| DEFAULT | 자식 실체 인스턴스의 입력을 항상 허용하고, 대응되는 부모 건이 없는 경우 참조키(FK)를 지정된 기본 값으로 처리 | 부모 실체 인스턴스의 삭제를 항상 허용하고, 대응되는 자식 실체의 인스턴스가 존재하면, 그것의 참조키(FK)를 기본값으로 수정 |
| CUSTOMIZED | 특정한 검증 조건이 만족되는 경우에만 자식 실체 인스턴스의 입력을 허용 | 특정한 검증 조건이 만족되는 경우에만 부모 실체 인스턴스의 삭제를 허용 |
| NO EFFECT | 자식 실체 인스턴스의 입력을 조건 없이 허용 | 부모 실체 인스턴스 삭제를 조건 없이 허용 |
관계도 속성이다.
속성들은 서로 독립적이고 식별자에만 종속되어야 한다.